Agents, Loops, Graphs
本文整理自 Mahaximus 关于 Agent 工作流的长推文笔记。
现代 AI Agent 系统可以粗略拆成三层:
- Agent:负责自主决策
- Loop:负责反复执行与纠错
- Graph:负责拆分任务与并行执行
三者的分工可以用一句话概括:
Agent = 自主性
Loop  = 可靠性
Graph = 效率
组合起来,就是一个完整的执行链条:
Goal → Agent → Loop → Graph → Workers → Checker → Synthesis → ResultAgent 是什么
普通 Chat 的流程是:
用户提出问题 → LLM 生成回答 → 结束Agent 的流程则是:
用户提供目标 → 分析任务 → 选择工具 → 执行任务 → 检查结果 → 继续执行 → 完成目标Agent 和普通聊天最大的区别不是一定用了更强的模型,而是模型外围增加了更多能力。一个典型 Agent 通常包含:
LLM + Tools + Memory + LoopTools
Agent 可以主动调用工具:Web Search、文件系统、Shell、Python、数据库、API、浏览器、Git、测试工具……
关键区别在于:普通聊天是用户告诉 AI「现在搜索网页」,Agent 是 AI 自己判断「这里需要搜索网页」。
Agent 不只是执行指令,还需要决定下一步应该做什么。
Memory
Agent 需要保存任务状态:已经执行了哪些操作、哪些方法失败了、当前进度、已经获取的信息、做过哪些决策、下一步需要做什么。否则每一步都会像第一次执行任务一样。
Loop
Agent 的核心并不是「输入 → 生成一次 → 结束」,而是:
Goal → Plan → Execute → Check → Fix → Execute → ... → DoneAgent 真正重要的能力是:持续工作,直到任务达到完成条件。
Agent 的四个等级
| 等级 | 结构 | 特点 |
|---|---|---|
| 1. Chat | User → LLM → Answer | 无工具、无持续目标、无自动循环,人负责控制流程 |
| 2. LLM + Tools | 模型自主决定何时调用工具 | 有了手,但每次动作仍需人来安排 |
| 3. Multi-step Workflow | 用户只给最终目标,Agent 自动拆分、执行、验证、汇总 | Claude Code、Codex、Cursor Agent、Devin 都属于这一类 |
| 4. Fully Autonomous | 事件或时间自动触发,无需用户每次启动流程 | 例如每天自动:搜新闻 → 筛选 → 验证来源 → 生成日报 → 发送 |
Level 1 的本质是:AI 是工具,人是执行引擎。而 Level 3 之后,执行引擎的角色逐渐交给了 Agent 本身。
Loop:让任务真正完成
普通 Prompt 的终点是「模型生成结束」,而 Loop 的终点是「任务真正完成」。一个标准的 Loop:
Goal → PLAN → EXECUTE → CHECK → ITERATE → STOPCHECK 是整个 Loop 最重要的一步
不能只是 AI 说「看起来应该没问题」,而要存在真正可以判断成功或失败的标准。例如:
- 代码:
pytest输出32 / 32 passed - 覆盖率:
Coverage >= 80% - RAG 评测:
Recall@5 >= 0.85 - API:
HTTP Status = 200 - 部署:
/health返回healthy
Check 最好是可验证、可量化、可失败的。
没有 Check 的 Loop 没有意义
如果 Loop 是「生成结果 → AI 自己评价 → 继续修改 → 再自己评价」,那可能永远在「感觉更好了」,却无法真正知道任务有没有完成。
真正有效的 Loop 应该是:
Action → External Check → Pass / Fail而不是:
Action → Self FeelingSTOP 条件
Loop 不能无限运行,必须设置停止条件:
if success:
    stop
else if attempts >= 8:
    stop and report failure
else:
    continue
否则就是「失败 → 修改 → 失败 → 修改」的死循环,大量消耗 Token、时间、API 成本和计算资源。
一个标准 Loop 模板
目标:完成 X。

验收标准:
1. 条件 A
2. 条件 B
3. 条件 C

每轮执行:
1. DRAFT   — 生成或修改结果
2. SCORE   — 对所有标准进行检查
3. GAPS    — 找出当前最大问题
4. CALL    — 全部达标 → DONE;否则 → NEXT PASS,优先修复最弱部分

最大循环次数:N 次
Graph:依赖图与并行
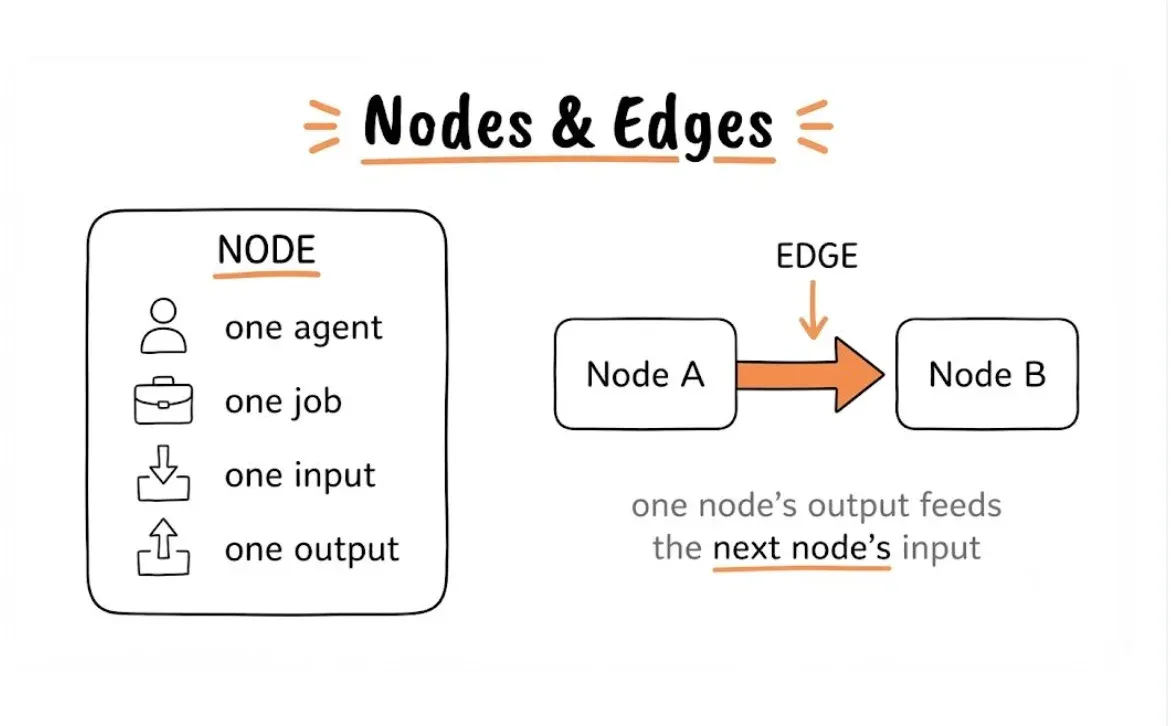
Graph 不是普通意义上的图表,而是任务依赖图,由 Node 和 Edge 组成。
- Node 表示一个任务,最好做到「一个输入 + 一个任务 + 一个输出」
- Edge 表示任务依赖关系
结构化输出是自动执行的前提
Graph 要实现自动执行,非常依赖结构化输出(JSON、Schema、Pydantic Model)。Worker 输出「我查了一下,我觉得这家公司价格大概是……」会让后续 Agent 很难稳定处理;而结构化 JSON 可以无缝传递给下一个 Node。
Fake Edge:最容易被忽略的概念
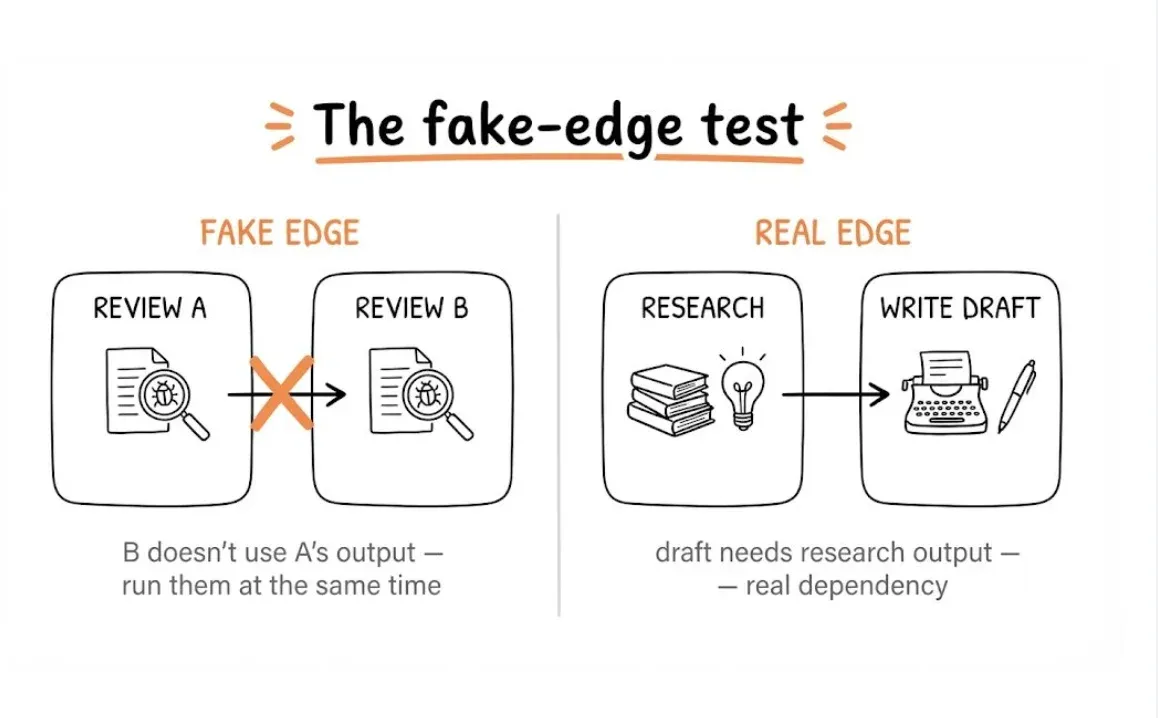
很多任务只是我们习惯顺序执行,但实际上不存在依赖。比如「研究 OpenAI → 研究 Anthropic → 研究 Google」,Anthropic 的研究并不需要等待 OpenAI 的研究完成。这种 Edge 是 Fake Edge,正确做法是三个任务并行执行,最后汇总。
Diamond Pattern
Agent Workflow 中最经典的结构——Fan-out + Converge:
              Worker A
             ↗
Input → Worker B → Synthesis → Output
             ↘
              Worker C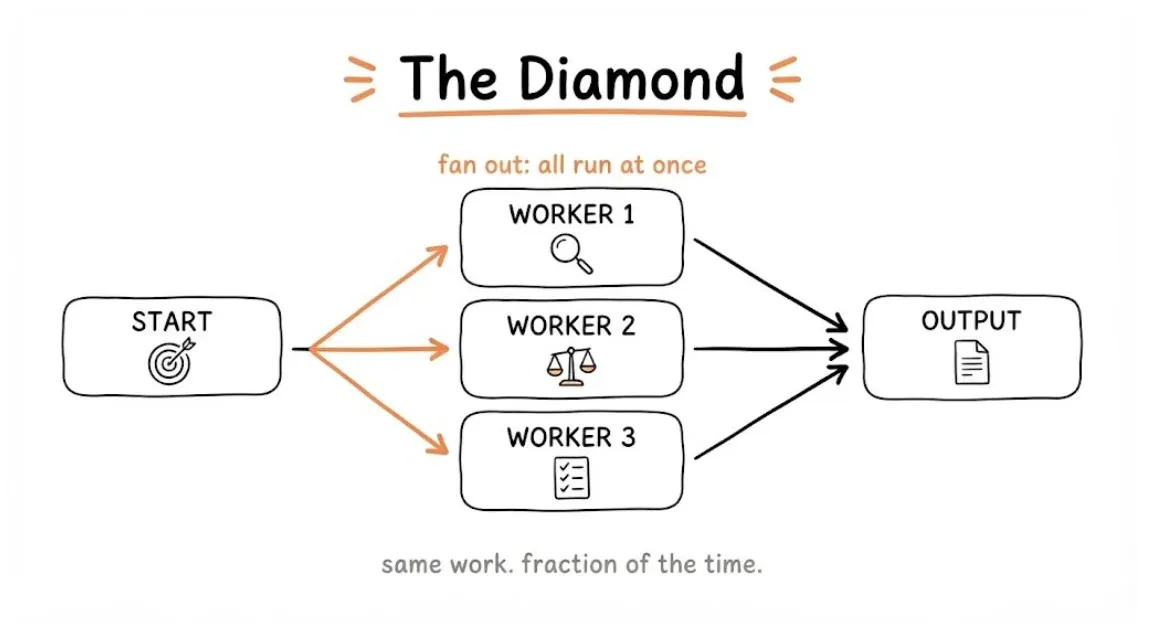
假设三个任务各需 10 分钟:串行总耗时约 30 分钟,并行后约 10 分钟加一次汇总。Graph 的重要作用之一,就是找到没有真正依赖关系的任务,并行执行。
Checker:不要自己给自己打分
执行任务的 Agent,不应该完全依赖自己检查自己的结果。
产生错误的 Agent,很可能无法意识到自己的错误——用相同的上下文去检查,往往「仍认为正确」。所以建议结构是 Worker → Checker → Final,而不是 Worker → Worker 自己评价。
Checker 使用 Fresh Context,只看最终结果、原始任务和验收标准,不一定需要看到 Worker 的完整推理过程。复杂任务甚至可以用多个 Checker:Correctness(内容是否正确)、Freshness(信息是否过时)、Source(来源是否可靠),最后 Voting 汇总。
三者组合:Coding Agent 实例
以「修复登录模块 Bug」为例:
读取项目 → 搜索相关代码 → 定位问题 → 修改代码 → 运行测试如果测试失败,则「读取错误 → 重新分析 → 修改 → 再次测试」——这就是 Loop。
如果同时排查前端登录逻辑、后端 JWT、Redis Session、数据库查询,且互相独立,则拆成四个并行 Agent——这就是 Graph。
最后的 Reviewer / Tests——这就是 Checker。
Harness:之上的工程系统
Harness 可以理解为:包裹模型并让 Agent 真正执行任务的工程运行环境。
                 Harness
┌──────────────────────────────────┐
│  LLM、Tools、Memory              │
│  Context Management、Rules、Skills │
│  Loop、Checker、Sandbox           │
│  Graph / Workers                 │
└──────────────────────────────────┘
如果说 Agent 描述的是「AI 如何自主完成任务」,Harness 描述的则是「用什么工程系统支撑这个 Agent 可靠运行」。过去我们关注 Prompt Engineering(怎么把一句 Prompt 写得更好);现在 Agent 越来越复杂,更需要关注 Harness Engineering:给模型什么工具、如何控制上下文、如何管理 Memory、如何定义权限、如何建立 Loop、如何设置 Check 和 Stop Condition、如何设计任务 Graph、如何防止无限循环、如何控制 Token……
同一个模型,差的 Harness 可能远不如好的 Harness。
LangGraph 的位置
LangGraph 的核心思想与 Graph 非常接近:
START → Planner → Research → Tool → Checker → Should Continue?
                                        ├─ Yes → Research
                                        └─ No → END
本质是 Graph + State + Loop + Conditional Edge。所以 LangGraph 不是为了「画流程图」,而是为了构建 Stateful Agent Workflow。
几个容易被误解的点
- Agent ≠ Model:Agent 更接近 Model + Tools + State + Memory + Workflow + Loop
- Check 比 Prompt 更重要:对很多工程任务,「怎样判断结果正确」甚至比「怎样告诉模型做事」更重要
- 可自动验证的任务最适合 Agent:Coding、Testing、SQL、Data Processing、Deployment、RAG Evaluation——因为它们都容易构造 Objective Check
- Graph ≠ Multi-Agent:Graph 中可以是多个 Agent,也可以是同一个 Agent 在不同 Node 被调用多次。Multi-Agent 只是 Graph 的一种实现方式
成熟 Agent 系统的 Checklist
- Model:用什么模型?不同任务是否需要不同模型?
- Tool:模型有哪些工具?权限如何限制?
- Memory:保存什么信息?保存多久?
- Context:什么内容进入上下文?如何避免爆炸?
- Loop:什么情况下继续?什么情况下停止?
- Check:如何判断完成?是否存在外部验证?
- Graph:哪些任务有真正依赖?哪些可以并行?
- Worker:是否需要多个 Worker?输出是否结构化?
- Checker:是否需要独立审核?是否需要 Fresh Context?
- Safety:是否允许写文件、执行 Shell、修改数据库?是否需要用户确认?
总结
LLM → Tools → Agent → Loop → Graph → Checker → HarnessLLM 提供智能,Tools 提供执行能力,Agent 提供自主决策,Loop 让系统持续纠错,Graph 让复杂任务拆解并行,Checker 提高可靠性,Harness 把这一切组织成真正可运行的 Agent 系统。
Agent 负责决定做什么,Loop 负责确保做到,Graph 负责让它做得更高效,而 Harness 负责让这一整套东西稳定地运行起来。