Jev 详解:TypeSafe 的语义决策引擎
本文整理翻译自 @akshay_pachaar 关于 Jev 的推文。
我们一直在像用锤子一样把 LLM 用在每一个 AI 问题上,哪怕只是一个简单的判断。Jev 能在毫秒级、以几分之一的成本完成这些判断。下面来看看它的工作原理,以及它适合用在哪里。
TypeSafe 于 2026 年 9 月 15 日发布了 Jev,反响异常强烈——对于一个不会对话、不会写代码、连一段有用的文字都生成不了的模型来说。
不过,这种「局限」正是它的意义所在。
大多数软件需要的并不是另一个聊天机器人,而是成千上万次的小判断,例如:这个工单紧急吗?这个请求该由哪个模型处理?这条 shell 命令危险吗?这段检索到的内容能回答这个问题吗?
团队通常把每一次判断都交给通用 LLM。模型一个 token 一个 token 地生成答案,应用程序解析它、校验它,格式不对就重试。这确实可行,但对一个只有五个候选答案的判断来说,又慢又贵。
Jev 就是为这类判断而生的。TypeSafe 称它为 System One 模型:非结构化的状态进去,类型化的答案和概率出来。
下面来拆解这句话的含义、它的定位,以及营销上需要收敛一点的地方。
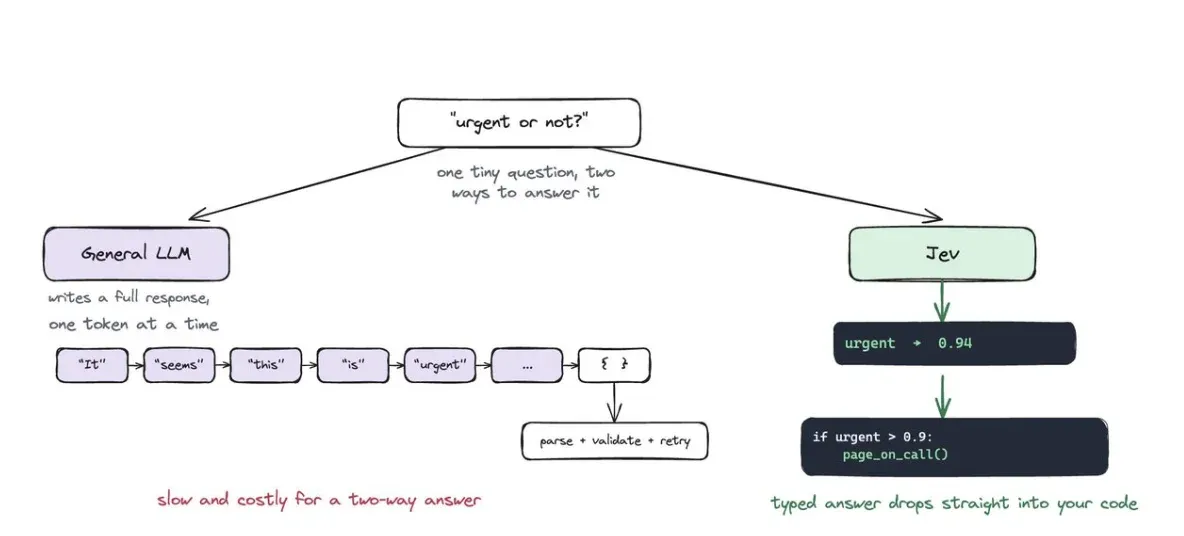
首先,Jev 解决的是什么问题
有了工具调用和结构化输出之后,LLM 接入软件的难度大大降低。
工具调用让模型能以可预测的结构请求一个函数;结构化输出让它返回符合 schema 的 JSON。两者都消除了大量脆弱的解析工作。
但底层模型依然是生成式的。即使答案只是一个词 “billing”,它仍然逐 token 地生成。你为输入付费,等待生成,而且往往还要为输出付更多的钱。
现在把它放进一个 Agent 循环里:
while not done:
    action = llm(context)
    result = run_tool(action)
    context += result
模型可能会被反复调用:选择工具、判断结果、检测风险、决定任务是否完成、挑选下一个模型。一次 Agent 运行中可能包含大量只需要判断、不需要生成文字的调用。
Jev 瞄准的就是这些调用。
它的赌注很简单:当代码已经知道所有可能的答案时,语言生成就是错误的接口。
Jev 到底是什么
最准确的一句描述是:语义决策引擎(semantic decision engine)。
你给 Jev 两样东西:
- State(状态):描述当前情况的文本或 JSON。
- Questions(问题):你想让它对这个状态做出的决策。
每个问题都提前声明了答案的形状。Jev 支持三种原语:
- Choice(选择):从你定义的选项列表中选一个,并为每个选项返回概率。
- Score(打分):把输入放到你定义的有序刻度上,比如低、中、高。
- Noul:回答一个是非题,返回它为真的概率。
Noul 是 TypeSafe 给布尔型原语起的名字。这个不寻常的名字没那么重要,重要的是它的输出——一个介于 0 和 1 之间的数字,你的代码可以直接据此行动。
{
  "model": "jev-latest",
  "state": "The deploy failed twice and customers are seeing 500s.",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "Does this need attention right now?"
    },
    "owner": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "engineering": "Product failures and outages",
        "billing": "Charges, invoices, and refunds",
        "sales": "Pricing and new accounts"
      }
    }
  }
}
响应包含一个紧急程度概率,以及三个团队上的概率分布。没有需要解读的段落,也没有模型凭空发明的第四个团队。
你的程序始终掌握控制权:
if urgent > 0.9 and owner == "engineering":
    page_on_call()
elif confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(owner)
这就是为什么人们一直把 Jev 叫做「聪明的 switch 语句」。这个说法听起来像贬低,但它恰恰抓住了设计中有用的部分:普通代码拥有分支,模型提供普通代码无法可靠计算的模糊判断。
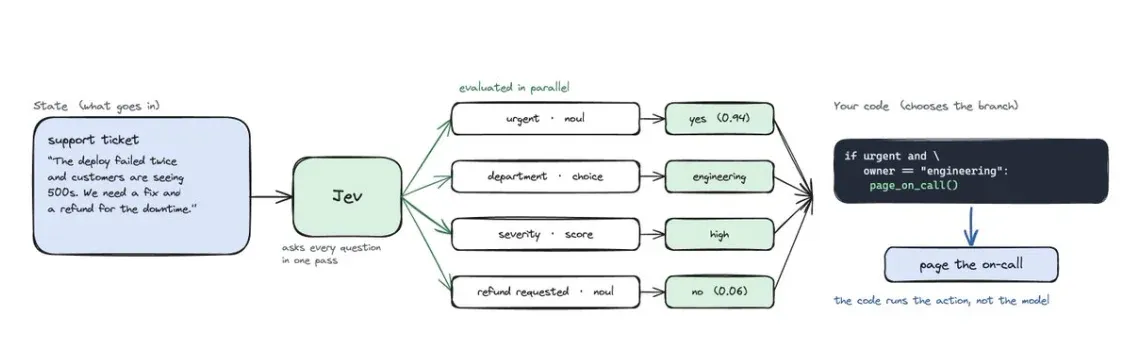
与 LLM 的关键区别
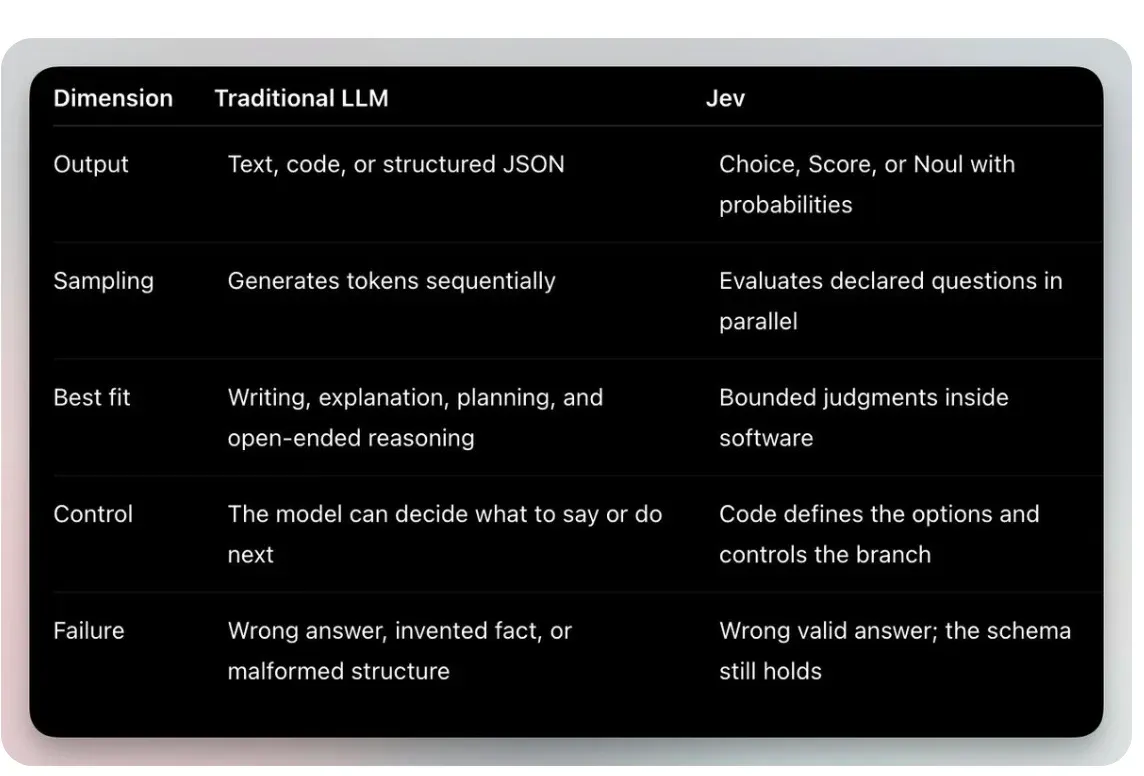
传统 LLM 和 Jev 都能给支持工单分类。它们得到答案的方式不同,在系统中适合的位置也不同。
TypeSafe 表示,Jev 会并行评估一个请求中的每个问题。这会改变你设计工作流的方式:不必一次问一个问题、等待、再决定下一个问题问什么,而是可以在一个请求里把针对同一状态的所有独立问题都问出来,让代码按需取用答案。
公司报告端到端延迟在 70 到 500 毫秒之间,价格为每百万输入 token 0.042 美元,输出免费。其宣传口径是比同类 LLM 工作流快约 200 倍、便宜约 400 倍。
这些大倍数来自 TypeSafe 自己的工作流评测,处于对比的有利一端。把它当作上限,而不是每个应用都能兑现的承诺。底层优势依然可信——Jev 避免了长推理轨迹和生成式输出,因为它就是为有界决策设计的。
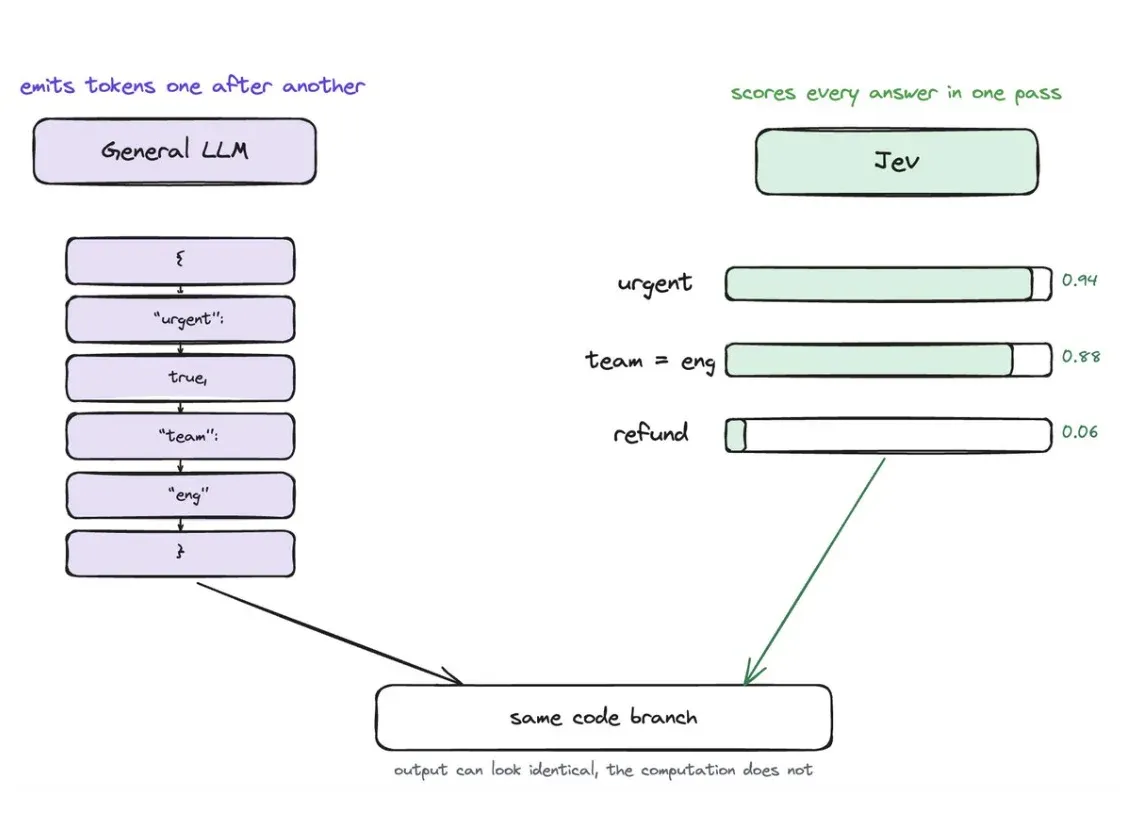
为什么概率很重要
类型化的答案只解决了一半问题。
假设 Jev 把一个工单路由给了 billing(计费)。选中的标签告诉你谁赢了,概率分布则告诉你这场竞争有多接近。
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.52,
    "technical": 0.46,
    "sales": 0.02
  },
  "confidence": 0.18
}
自动路由这个工单就太鲁莽了。Billing 赢了,但只是险胜。低置信度的答案应该触发另一条分支。
这给了开发者一个实用的模式:
- 高置信度:后果较小时自动执行。
- 中等置信度:请求确认,或调用更强的模型。
- 低置信度:转给人工,或收集更多信息。
阈值应该放在代码里,这样可以被审查和修改。仪表盘上的一个标签可以容忍弱预测;删除数据的命令则应该要求高得多的门槛。
TypeSafe 用 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)训练 Jev。目标是让置信度在许多次预测中真实反映准确率:如果模型对一组答案给出 90% 的概率,那么大约 90% 的答案应该是对的。
「不会幻觉」的说法需要更精确
TypeSafe 说 Jev 不会幻觉。这句话只在很窄的定义下成立。
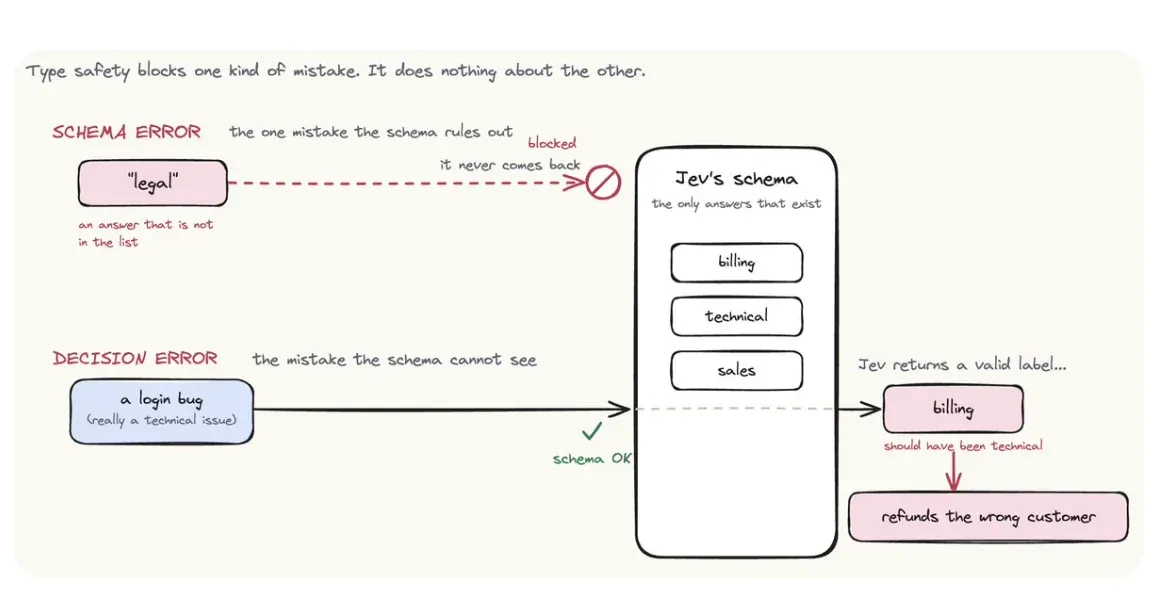
Jev 不能返回 schema 之外的选项。如果你定义了 billing、technical 和 sales,响应就不可能凭空造出 legal。它也不可能在你代码期望标签的地方生成格式错误的文字。
但它可能自信地选出一个错误的合法选项。
类型安全防止的是无效形状,不保证判断正确。这个区别很重要,因为一个 schema 合规的错误仍然可能给错误的客户退款、把事故路由错、或者批准一条危险的命令。
更稳妥的说法是:「Jev 不会打破声明的输出 schema,但它仍然可能犯错。」
Jev 在 Agent 中的位置
Jev 最适合与 LLM 搭配使用,而不是取代它。
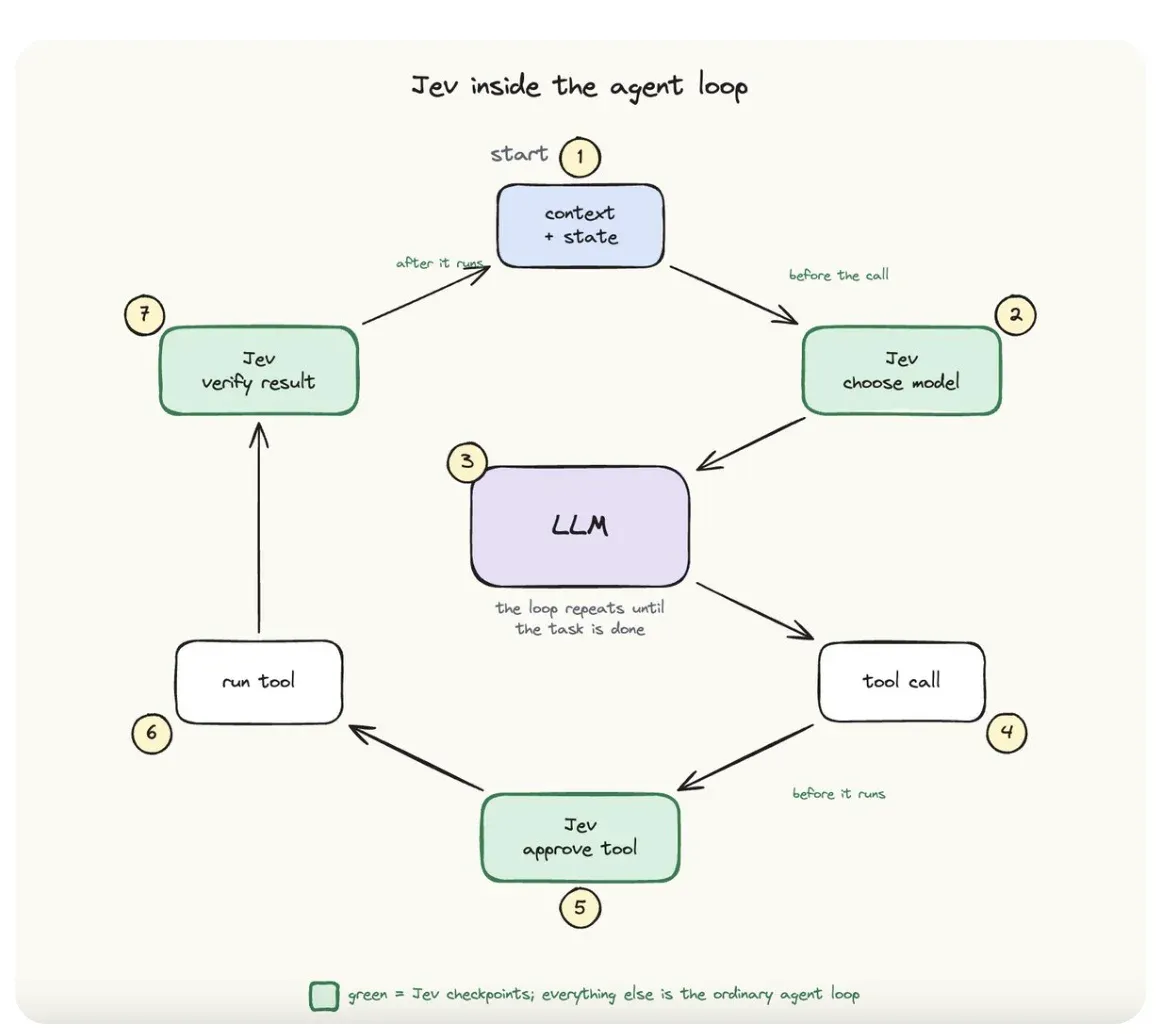
LLM 负责需要语言或更深推理的工作:规划、写作、解释、使用工具。Jev 负责这些工作周围的高频判断。
有三个位置尤其值得关注。
模型路由
一个简单查询不需要和架构评审用同一个模型。Jev 可以给请求打分,选出最有可能完成任务的最便宜模型。
route = jev.choice(
    state=user_request,
    options={
        "fast": "Lookups, extraction, and small local edits",
        "powerful": "Architecture, ambiguity, and high-stakes work",
    },
)

model = fast_model if route == "fast" else powerful_model
路由器不回答请求本身,它决定应该由哪个模型来回答。
工具风险门控
在 Agent 执行 shell 命令之前,Jev 可以把它分类为只读、可逆或破坏性。可以用不同的问题检查它是否会删除文件、改写 Git 历史、触碰生产环境、或离开当前仓库。
高置信度的只读操作可以继续执行;破坏性或不确定的操作暂停等待人工批准。LangChain 的 Jev 集成通过在执行前检查工具调用的中间件应用了这一模式。
验证与监督
Agent 可能声称任务已完成,而测试仍然失败。Jev 可以检查状态并回答有界的问题:测试通过了吗?Agent 是否在重复同样的动作?输出是否符合策略?这个结果需要人工复核吗?
它不会在有硬性测试的地方取代测试,而是在规则依赖语义的地方增加一道语义检查。
Jev 今天能解决的问题
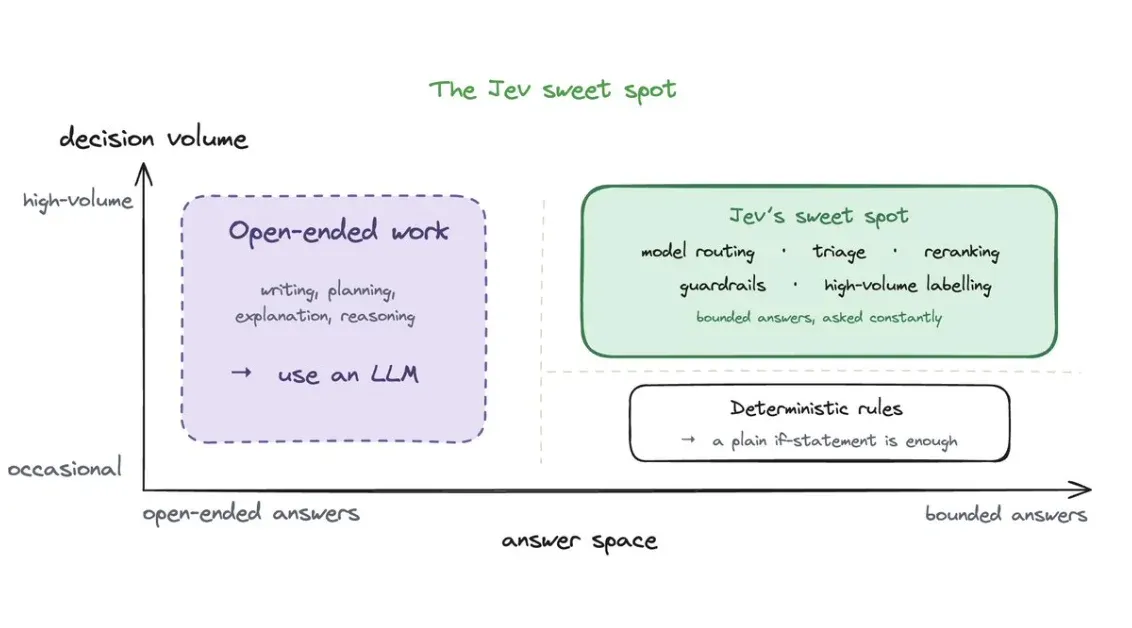
最好的用例共享三个特性:你能列举出所有可能的答案;一个细心的人能快速判断输入;决策发生的频率足够高,以至于延迟或成本真的重要。
支持与运维
- 分类意图、紧急程度、部门、垃圾信息和客户情绪。
- 通过几个小检查来路由退款和政策例外。
- 在人工查看之前,按语义严重程度给日志和事故排序。
一个请求可以就同一个工单问出所有这些问题,然后由代码把答案组合成公司实际的路由策略。
搜索与检索
- 按「是否回答了查询」给检索到的段落重排。
- 检查引文是否支持某个论断。
- 在把上下文发给昂贵的 LLM 之前,过滤掉不相关的片段。
Embedding 擅长找到语义相关的文本,Jev 能做更窄的判断:某一段内容对这个问题是否有用。
质量与安全
- 筛查提示词中的越狱或提示注入。
- 按策略或评分标准检查生成内容。
- 在风险代码变更或工具调用执行之前标记它们。
这些检查应该与确定性控制并排使用:语义分类器擅长模糊风险,而权限、沙箱和测试负责执行软件能精确验证的规则。
大批量分类
- 给文档、论文、商品列表或客户消息打标签。
- 把自由文本转成传统机器学习模型的特征。
- 用同一套评分标准给大语料库中的每一项打分。
这正是低单次调用成本超越基准数字的地方:一个原本贵到无法对每一行数据执行的判断,现在可以进入常规数据管道。
实时交互
- 从已知的页面元素中选择下一步浏览器动作。
- 在用户写作时给语气或清晰度打分。
- 从结构化的游戏或模拟器状态中选择一个动作。
Jev 目前只支持文本输入,所以这些系统必须先把环境转成文本或 JSON。它不会看屏幕,也不是从像素上玩游戏。
什么时候不该用 Jev
一旦答案空间不再已知,Jev 的用处就迅速下降。
- 它不能写回复、总结文档、生成代码或解释推理过程。
- 它在算术、计数、日期比较或精确字符串处理上不可靠,这些操作留在代码里。
- 当决策需要多个隐藏推理步骤时它会很吃力。把判断拆成更小的问题,或者改用推理模型。
- 它不能直接抽取未知值。先找到候选值,再让 Jev 从中选择。
- 无关上下文会降低准确率。只发送决策所需的状态。
- 闭源权重、早期访问、纯文本输入,以及有限的独立校准数据,都意味着现在还不到盲目信任的时候。
还有一个更简单的规则:如果确定性代码已经能正确解决问题,就保留代码。一个普通的 if 语句比任何模型都快、都便宜、都容易测试。
如何用 Jev 而不制造新的故障模式
一个便宜的模型仍然可能很贵——如果它的错误带来重试、人工复核或生产事故的话。要衡量整个工作流,而不是 token 单价。
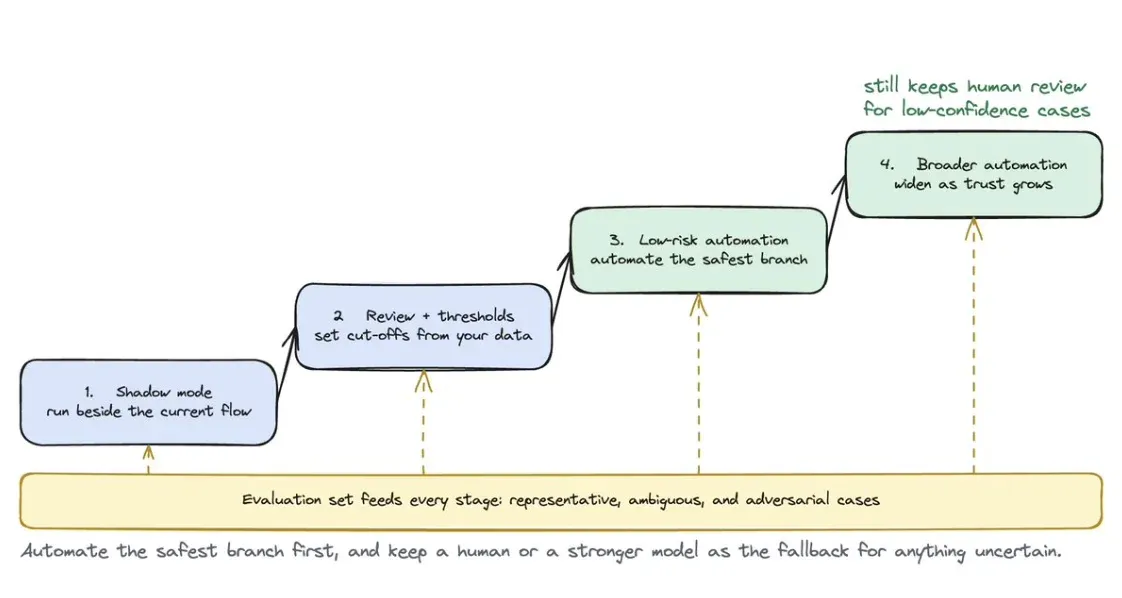
一个合理的落地路径是这样的:
- 选一个有界、低风险、答案空间明确的决策。
- 在调用模型之前先写好评判标准(rubric),定义每个选项该包含什么。
- 收集有预期答案的代表性样本,包括模糊和对抗性的例子。
- 让 Jev 以影子模式运行在现有工作流旁边,先不改变任何行为。
- 绘制准确率-置信度曲线,用你自己的数据设定阈值。
- 先自动化最安全的分支,不确定的案例保留人工或更强模型。
- 固定或记录模型版本、问题、标准和阈值,这样任何变更都能在同一个评测集上回放。
问题是程序的一部分。要像对待代码一样对待它们:版本化、评审,并在模型或标准变化时测试它们。
真正的转变
Jev 有意思的地方不在于它在写作上打败了 LLM——它拒绝写作。
它的贡献是一种长得像软件的模型接口:固定的答案类型、显式的不确定性、并行的问题、由代码控制的分支。
这使它成为生成式模型的有用伴侣。LLM 产出计划、解释或代码;Jev 路由请求、门控风险动作、检查结果,并在不确定性高到需要升级时做出判断。
即使将来有别的模型取代 Jev,这个更宏观的想法依然成立。多年来我们一直在让生成式模型通过文本来完成每一种智能。很多生产系统并不需要更多的文字,它们需要的是一个小的、快速的判断,让普通软件可以安全地使用。
这正是 Jev 试图建立的品类。
从哪里开始
不要一上来就把整个 Agent 围绕 Jev 重建。先找到一个当前需要慢速 LLM 调用、或者正则不断出错的决策。
给 Jev 最小的状态、定义好可能的答案、把它的概率记录在当前结果旁边。在你把整个工作流交给它之前,先让它证明自己值得拥有一个分支。
最有用的心智模型仍然是最简单的那个:Jev 在普通 if 语句看得懂值、但看不懂含义的地方,补充判断。